블로그
방문객을 알아볼 수 없게 만든 것이 설계다
카메라가 사람을 알아보는 거리는 얼굴에 맺히는 픽셀 수가 정한다. 그래서 프라이버시 한계를 문서가 아니라 광학에 새길 수 있다.
사양서에는 1080p라고 적힌다. 개인정보 페이지에는 지나가는 방문객을 식별하지 않는다고 적힌다. 둘 중 강제력이 있는 문장은 하나뿐이고, 개인정보 페이지 쪽이 아니다. 1080p 얼굴 인식 거리는 정책 문서가 쓰이기 전에 기하학이 이미 정해 놓는다. 그렇게 나온 숫자는 대부분이 짐작하는 것보다 짧다.
이 계산을 매일 하는 업계가 따로 있다. 보안 카메라 설계자들은 얼굴당 픽셀 수로 카메라를 고른다. 예산이 허락하는 한 인식 거리를 멀리 밀어내려고 한다. 같은 산수를 반대 방향으로 돌리면 전시 부스에 훨씬 쓸모 있는 것이 나온다. 이 하드웨어가 영원히 알아볼 수 없는 범위의 상한선이다. 설정 화면이 아니라 렌즈와 센서에 박힌 상한선이다.
1080p 얼굴 인식 거리는 1920픽셀 센서를 단 카메라가 얼굴에 신원을 붙일 만큼의 픽셀을 확보하는 최대 거리다. 카메라 브랜드도 프로세서도 소프트웨어도 이 값을 정하지 않는다. 센서의 가로 해상도와 렌즈의 가로 화각과 성인 얼굴 폭 16센티미터, 이 세 숫자가 정한다. 셋을 나누면 1도당 픽셀이 나오고 거기서 거리별 얼굴 폭 픽셀이 따라 나온다. 얼굴이 있다는 것만 판정하는 검출에는 20~30픽셀이면 되고 저장된 임베딩과 대조해 신원을 붙이는 인식에는 100픽셀 가까이 필요하다. 두 문턱 사이가 벌어져 있고 그 사이에 프라이버시 보증이 들어설 자리가 있다. 카운터에 앉은 사람은 인식 쪽에 들어오고 통로에 선 사람은 검출 쪽에 남는다. 그 경계를 옮기려면 렌즈나 센서를 바꿔야 하고 설정 화면에서는 손댈 수 없다. 개인정보 처리방침이 약속하는 것과 하드웨어가 못 하는 것은 다른 종류의 문장이다. 이 글의 숫자는 전부 하드웨어 요구사항을 정하려고 돌린 산수다. 만들어진 기기를 실측한 값이 아니다. 실측할 기기가 아직 없다. 아래는 그 산수를 어디까지 밀 수 있는지와 어디서 낙관적인지를 함께 적은 것이다.
얼굴 인식 거리를 정하는 것
얼굴 인식 거리는 임베딩 모델이 신원을 붙일 만큼의 픽셀이 얼굴에 맺히는 최대 거리다. 카메라 브랜드나 프로세서나 소프트웨어가 정하는 값이 아니다. 세 숫자에서 나온다. 센서의 가로 해상도, 렌즈의 가로 화각, 그리고 성인 얼굴 폭 16센티미터다. 셋 중 둘은 부품을 고르는 순간 확정되고 나머지 하나는 사람 몸이 정한다. 설정으로 바꿀 수 있는 항목이 하나도 없다. 넘어야 할 문턱도 취향의 문제가 아니다. Quinn과 Grother가 2011년 NIST 보고서 Performance of Face Recognition Algorithms on Compressed Images에서 측정해 두었다. 인식 정확도를 확보하려면 두 눈 사이가 96픽셀 아래로 내려가서는 안 되고, ISO/IEC 19794-5가 요구하는 60픽셀보다 엄격하며, 96픽셀을 넘겨도 정확도에서 체감할 이득은 없다고 적혀 있다. 아래 산수가 겨냥할 과녁이 그래서 고정된다.
이 셋이 도 단위 픽셀 밀도를 고정한다. 가로 1920픽셀 센서에 120도 렌즈를 물리면 1도당 16픽셀이다. 폭 16센티미터 얼굴은 1미터에서 약 9.1도를 차지한다. 1.5미터에서 6.1도, 3미터에서 3.1도다. 곱하면 1미터에서 얼굴 폭 146픽셀, 3미터에서 49픽셀이 나온다. 얼굴이 있다는 것만 판정하는 검출에는 20~30픽셀이면 된다. 저장된 임베딩과 대조해 신원을 붙이는 인식에는 100픽셀 가까이 필요하다. 두 문턱 사이의 간격, 거기에 프라이버시 보증이 들어설 자리가 있다. 카운터 거리와 통로 거리가 그 간격의 양쪽에 떨어진다.
두 문턱이 그렇게까지 벌어지는 건 두 작업이 서로 다른 것을 요구해서다. 검출은 얼굴처럼 생긴 영역이 있는지만 판정한다. 눈 둘과 코 하나가 이루는 배치가 보이면 된다. 20픽셀 폭에서도 그 배치는 남는다. 인식은 그 얼굴을 저장된 다른 얼굴과 구별해야 한다. 눈꼬리 각도, 코 너비와 입 너비의 비율, 광대 윤곽처럼 사람마다 다른 미세한 값들이 살아 있어야 한다. 임베딩 모델은 정렬된 얼굴을 112픽셀 정사각형으로 받는다. 원본에서 이미 100픽셀 아래로 내려온 얼굴을 거기에 맞춰 늘리면 없던 디테일이 생기지 않는다. 보간이 만든 매끄러움만 늘어난다.
같은 이유로 이 한계는 소프트웨어로 메워지지 않는다. 초해상도 모델을 붙여 얼굴을 키우면 사람 눈에는 선명해 보인다. 그 모델이 채워 넣은 픽셀은 학습 데이터가 그럴듯하다고 본 값이지 그 사람에게서 온 값이 아니다. 신원 대조에 쓰면 그럴듯한 남을 만들어 낸다. 없는 정보를 지어내는 쪽이 없는 정보로 남겨 두는 쪽보다 프라이버시에 나쁘다.
아래 숫자는 전부 하드웨어 요구사항을 정하는 산수다. 만들어진 기기를 실측한 값이 아니다. 실측할 기기가 아직 없다.
계산과 그 계산을 내는 스크립트
함수 둘이 전부를 처리한다. 하나는 해상도와 화각과 거리를 받아 얼굴 폭 픽셀을 내놓는다. 다른 하나는 그걸 뒤집는다. 목표 픽셀이 유지되는 최대 거리를 돌려준다. 표준 라이브러리만 쓴다. 파이썬 프롬프트에 그대로 붙여 넣고 가정을 바꿔 다시 돌려 볼 수 있다. 얼굴 폭이든 화각이든 숫자를 바꾸면 결과가 어디로 움직이는지 바로 보인다. 검산이 되는 주장만 이 글에 실었다.
import math

FACE_W = 0.16  # 성인 얼굴 폭, 미터

def face_px(hres, hfov, d):
    """거리 d에서 얼굴 폭에 맺히는 픽셀 수"""
    return math.degrees(2 * math.atan(FACE_W / 2 / d)) * (hres / hfov)

def dist_for_px(hres, hfov, px):
    """목표 픽셀 px가 유지되는 최대 거리"""
    deg = px / (hres / hfov)
    return FACE_W / 2 / math.tan(math.radians(deg) / 2)

# 검출 25px / 인식 최저 80px / 인식 권장 100px
for hres, hfov in [(1280, 120), (1920, 120), (1920, 90), (2560, 120), (3840, 120)]:
    print(hres, hfov, [round(dist_for_px(hres, hfov, p), 1) for p in (25, 80, 100)])
정방향으로 돌리면 픽셀 예산이 이렇게 나온다.
| 해상도 / 화각 | 1m | 1.5m | 2m | 3m |
|---|---|---|---|---|
| 720p / 120도 | 98px | 65px | 49px | 33px |
| 1080p / 120도 | 146px | 98px | 73px | 49px |
| 1080p / 90도 | 195px | 130px | 98px | 65px |
| 1440p / 120도 | 195px | 130px | 98px | 65px |
표에서 1080p 90도 줄과 1440p 120도 줄이 같은 값인 건 우연이 아니다. 도당 픽셀 밀도가 해상도를 화각으로 나눈 값이라 둘 다 21.3픽셀이 된다. 화각을 좁히는 것과 해상도를 올리는 것이 인식 거리에는 같은 일을 한다.
값이 같아도 대가는 다르다. 화각을 90도로 좁히면 인식 거리는 1.5미터에서 2.0미터로 늘고 센서도 인코더도 그대로다. 대신 카운터 양끝이 화면 밖으로 나간다. 왼쪽 자리와 오른쪽 자리를 한 대로 덮으려던 배치가 무너진다. 해상도를 1440p로 올리면 화각은 지키지만 픽셀레이트가 78퍼센트 늘어난다. 카메라 세 대분이면 인코더 예산을 다시 짜야 한다. 어느 쪽도 공짜가 아니다. 이 표가 사양서가 아니라 설계 노트에 있는 이유가 그거다.
역방향으로 돌리면 같은 숫자가 거리로 바뀐다. 부스 배치를 정할 때 실제로 필요한 형태다.
| 해상도 / 화각 | 검출 한계 25px | 인식 최저 80px | 인식 권장 100px |
|---|---|---|---|
| 720p / 120도 | 3.9m | 1.2m | 1.0m |
| 1080p / 120도 | 5.9m | 1.8m | 1.5m |
| 1440p / 120도 | 7.8m | 2.4m | 2.0m |
| 4K / 120도 | 11.7m | 3.7m | 2.9m |
1080p에 120도 화각이면 인식은 약 1.5미터까지 성립하고 검출은 5.9미터까지 닿는다. 3미터에 선 사람이 있다는 건 안다. 그게 누구인지는 알 방법이 없다.
두 표를 겹쳐 읽으면 검출과 인식이 같은 카메라의 다른 능력이라는 게 드러난다. 검출 한계 5.9미터와 인식 한계 1.5미터 사이에는 4미터 넘는 구간이 있다. 부스 앞 통로 전체가 그 구간에 들어간다. 그 구간의 사람은 위치와 머문 시간으로만 존재한다. 이름표가 붙지 않는다.
720p가 탈락하는 이유
720p는 예산이 아니라 요구사항에서 떨어진다. 가로 1280픽셀에 120도면 인식 권장치 100픽셀이 1.0미터에서 끝난다. 최저치 80픽셀은 1.2미터다. 상담 테이블은 그보다 넓다. 테이블 건너편에 앉은 직원은 시스템이 감당해야 할 범위 밖으로 나간다. 상담 자리 안쪽이 이미 인식 거리 밖이라는 뜻이다. 해상도를 올려서 푸는 문제이지 소프트웨어로 푸는 문제가 아니다.
솔깃할 이유는 분명히 있다. 720p는 모든 방향에서 동시에 싸다. 인코더가 감당할 픽셀레이트가 절반이 된다. 전시 하루치 저장 용량이 줄고 전송 시간이 짧아진다. 벤더 문서가 720p 기준 용량을 적어 두는 이유가 그거다. 그 숫자는 카드 용량을 가늠하는 데는 쓸모 있고 캡처 프로파일을 고르는 데는 못 쓴다.
여기서 나오는 규칙은 사양을 깎는 보통의 순서와 정반대다. 저장 공간이 모자라면 비트레이트를 내리고 프레임레이트를 내린다. 해상도는 건드리지 않는다. 비트레이트와 프레임레이트는 파일 크기와 맞바꾸는 값이라 되돌릴 수 있다. 해상도는 인식 요구사항을 역산해 나온 값이다. 조용히 내리면 인식 상한선이 테이블 안쪽으로 들어온다. 녹화 프레임레이트와 추론 프레임레이트를 나눠 묻는 이유도 같은 논리다. 안전한 방향은 높게 녹화하고 낮게 샘플링하는 쪽이다.
2미터 밖에 선 사람에게 이 숫자가 뜻하는 것
2미터에서 얼굴은 1080p 120도 기준 73픽셀이다. 검출 문턱보다는 위고 인식 최저치 80픽셀보다는 아래다. 그 거리의 사람은 존재로만 남는다. 대략 저기에, 대략 그만큼 서 있었다는 것까지다. 누구인지 말할 픽셀이 없다. 센서가 애초에 담지 않은 정보는 어떤 후처리로도 복원되지 않는다. 통로를 지나가는 사람 대부분이 이 거리 바깥에 있다.
존재와 신원은 다른 데이터다. 이 구분은 짚어 둘 값어치가 있다. 위치와 체류 시간만 남은 기록은 그 자체로는 누구를 가리키지 않는다. 같은 사람이 어제도 왔는지 알 수 없다. 옆 부스에서 뭘 봤는지도 알 수 없다. 이름과 이어 붙일 열쇠가 없기 때문이다. 그 열쇠를 만드는 게 인식이고, 인식이 성립하지 않는 거리에서는 열쇠가 아예 생기지 않는다.
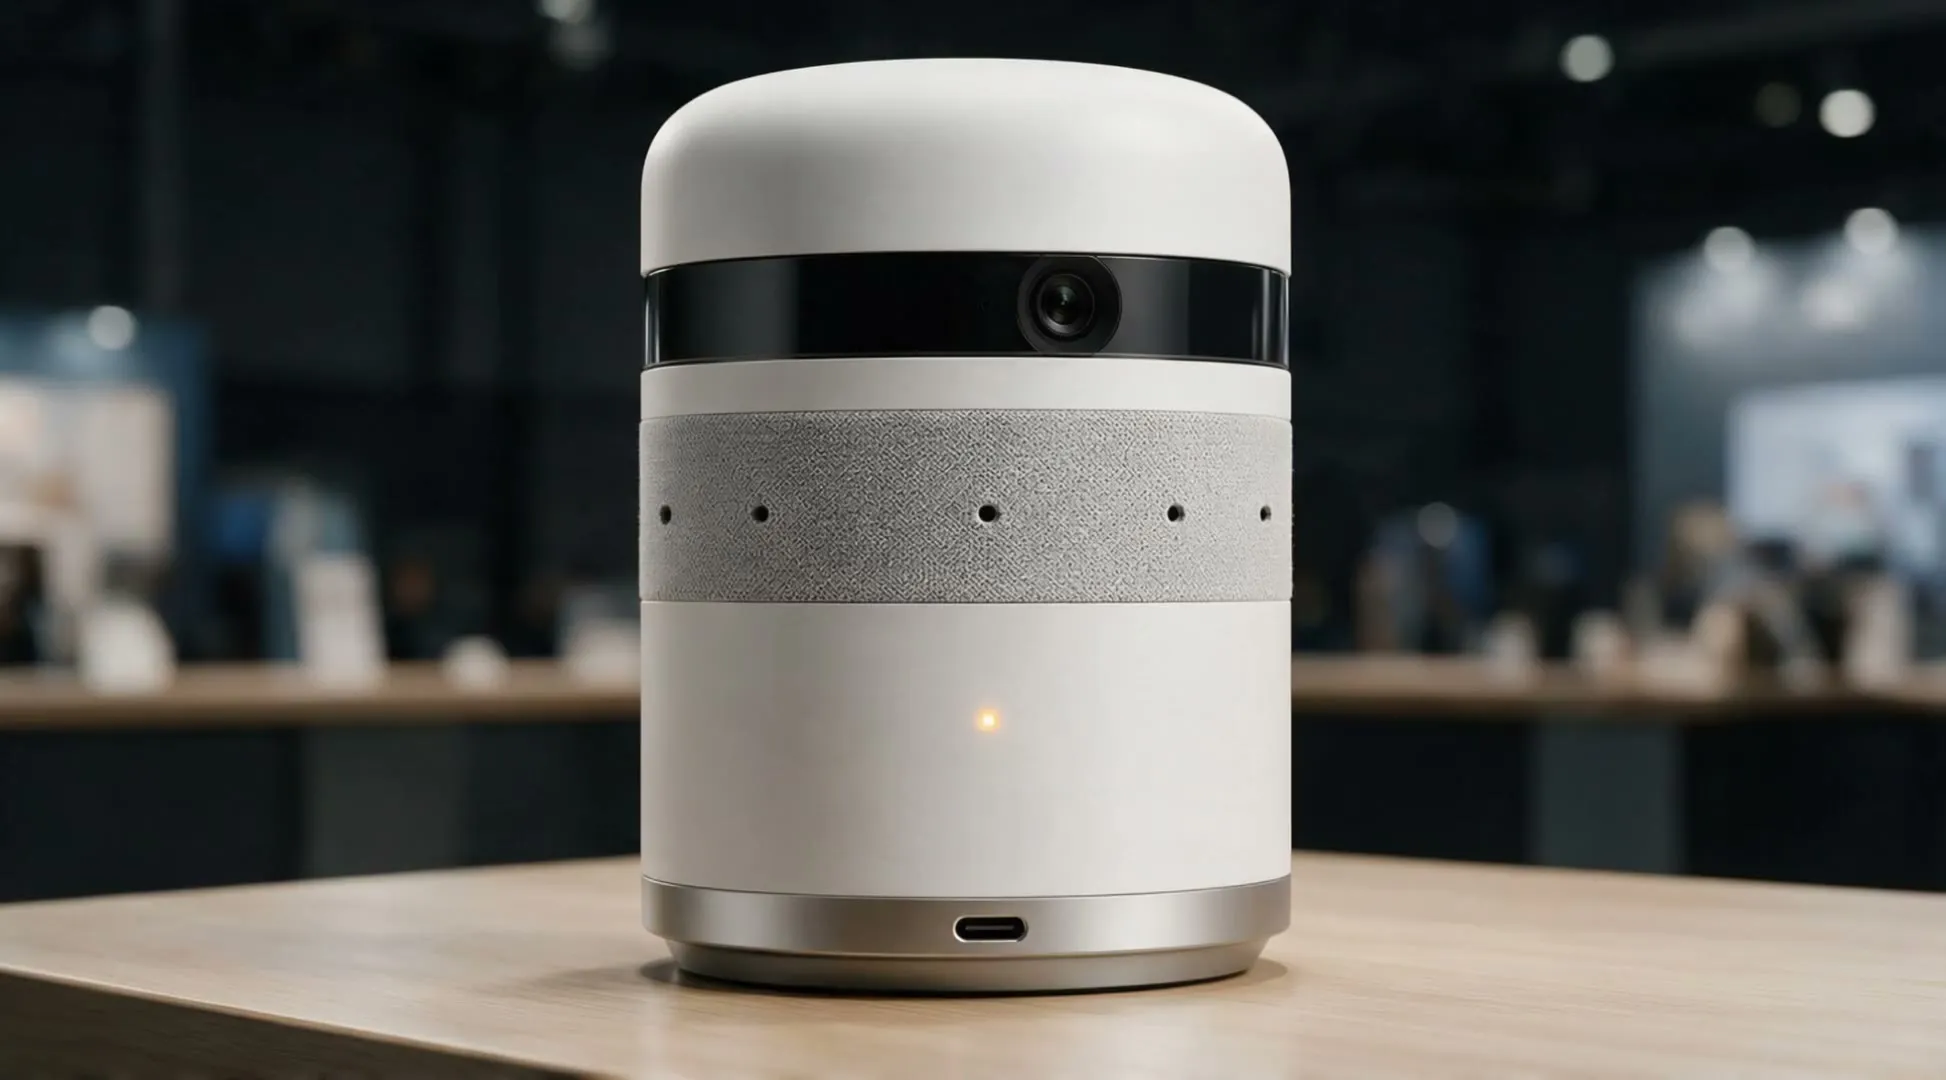
부스 기하학으로 옮겨 보면 경계가 분명해진다. 상담 테이블 건너편 직원은 1.5미터 안쪽에 앉는다. 신원 귀속은 설계상 그게 필요한 자리에서만 작동한다. 그 사람은 기기를 놓은 회사와 고용 관계가 있는 사람이다. 통로를 훑는 방문객은 2~3미터에 서서 위치만 있는 몸으로 남는다. 4미터로 스쳐 가는 사람은 검출에도 겨우 걸린다.
경계가 프라이버시 논리가 원하는 자리에 떨어지는 건 우연이다. 그 우연을 굳이 밝혀 두는 편이 낫다. 사람 얼굴 폭이나 아크탄젠트를 우리가 정하지 않았다. 우리가 한 결정은 경계를 테이블 끝에 놓는 해상도를 고르고 그 위로 올리지 않는 것뿐이다. 나중에 올리는 건 펌웨어 업데이트가 아니다. 재방문 방문객을 알아보려면 1440p 이상이거나 더 좁은 화각이 필요하다. 원가가 바뀌고 인코더 예산이 바뀌고 프라이버시 문답이 새로 붙는 사양 변경이다. 한계가 남는 이유는 둘이다. 옮기는 값이 비싸고, 옮기고 싶지 않다.
광학이 대신 지켜 주는 약속
방문객을 식별하지 않겠다는 문서상 약속은 펜을 쥔 쪽에 달려 있다. 정책은 고쳐 쓰인다. 새 주인은 그걸 개정할 권리까지 함께 물려받는다. 제재는 전시장 바닥이 다 쓸려 나간 뒤 몇 년 지나 온다. 광학적 상한선에는 그런 성질이 하나도 없다. 73픽셀에서 인식은 규칙에 막혀 보류된 게 아니다. 애초에 불가능하다.
이 한계를 각주가 아니라 기능으로 적는 이유가 여기 있다. 보안 카메라 업계는 똑같은 표를 “얼마나 멀리서 알아볼 수 있나”에 답하려고 낸다. 그 표의 모든 숫자는 밀어붙일 최대치다. 같은 표를 최소치 쪽으로 읽으면 값 하나 바꾸지 않고 목적이 뒤집힌다. 가장 믿을 만한 프라이버시 주장은 의도가 아니라 구조가 강제하는 쪽이다. 어떤 기록 장비든 마찬가지다.
문서 대신 하드웨어에 박아 둔 다른 규칙 하나와 짝을 이룬다. 녹음 표시등에는 끄는 스위치가 없다. 최소 밝기와 점멸이 앱이 닿지 못하는 펌웨어에 있기 때문이다. 두 선택의 모양은 같다. 정책이 약속했을 법한 것을 정책이 개정할 수 없는 자리로 옮긴다. 고지와 식별 한계는 부스 녹음을 다루는 법이 관할마다 묻는 바로 그 두 질문이기도 하다. 문구와 제재가 다를 뿐이다.
대가는 대칭이다. 그것도 짚어 두는 게 맞다. 통로의 모두를 식별하는 기기라면 더 나은 분석 제품이 된다. 그쪽을 원하는 구매자도 여럿 있다. 그 버전은 논거를 버리지 않고는 만들 수 없다. 복도를 덮으려면 웨어러블이 되어야 하고 그래서 복도는 그대로 비워 둔 것과 같은 구조다.
이 계산이 낙관적인 지점
위 숫자는 전부 낙관치다. 계산이 나온 설계 노트가 부록에 스스로 그렇게 적어 뒀다. 픽셀 예산은 화각 1도가 어디서나 같은 픽셀 수로 맺히는 이상적인 직선 투영을 가정한다. 실제 광각 렌즈는 그렇게 동작하지 않는다. 오차는 한 방향으로만 난다. 계산보다 나쁜 쪽이다. 어디가 얼마나 나쁜지를 아래에 항목별로 적었다. 실제 인식 거리는 위 표보다 짧아진다.
망가뜨리는 요인은 둘이다. 120도 렌즈는 가장자리를 압축해서 그 화각을 만든다. 주변부 얼굴은 도당 픽셀 계산이 예측한 것보다 적은 픽셀을 차지한다. 그런 채로 기하학적으로 일그러져 들어온다. 임베딩을 계산하기 전 정렬 단계에서 이미 정확도를 깎아먹는다. 여기에 렌즈 MTF가 광축에서 멀어질수록 떨어지는 문제가 겹친다. 같은 픽셀 수라도 주변부 픽셀이 담은 실제 디테일은 중앙보다 적다. 화면 가장자리의 98픽셀은 정중앙의 98픽셀과 같지 않다.
표에 미치는 결과는 직접적이다. 1.5미터라는 인식 거리는 화면 중앙 기준값이다. 가장자리로 갈수록 쓸 수 있는 거리가 줄어드는데, 얼마나 줄어드는지는 이 산수가 예측하지 못한다. 렌즈 개체와 왜곡 프로파일, 보정이 코너를 얼마나 감당하는지에 달려 있다. 부스 조명 수준에서 올라오는 센서 노이즈도 같은 방향으로 민다.
낙관치라는 사실이 논지를 흔들지는 않는다. 오차가 한쪽으로만 나기 때문이다. 실제 렌즈가 계산보다 나쁘다는 말은 방문객을 알아보지 못하는 거리가 1.5미터보다 짧아진다는 뜻이다. 프라이버시 한계는 더 단단해지고 인식이 성립해야 하는 테이블 건너편이 위태로워진다. 그래서 실측이 필요한 쪽은 프라이버시 주장이 아니라 직원 인식 쪽이다.
실측이 어떤 모양이어야 하는지도 지금 정해 둘 수 있다. 출하 렌즈를 붙인 실제 카메라를 카운터 높이에 두고 알려진 폭의 표적을 화면 중앙과 네 코너와 그 사이 지점에 각각 놓는다. 거리는 1미터부터 3미터까지 0.5미터 간격이면 충분하다. 각 위치에서 실제로 맺힌 얼굴 폭 픽셀을 세고 계산값과 나란히 적는다. 두 값의 비율이 위치별 감쇠 계수다. 그 계수를 표에 곱하면 이 글의 숫자가 사양이 된다. 그 전까지는 아니다.
측정해야 할 것이 하나 더 있다. 전시장 조명은 사무실 조명이 아니다. 스폿 조명이 얼굴 절반을 날리고 나머지 절반을 그림자에 넣는다. 픽셀 수가 충분해도 그중 절반이 포화되거나 뭉개져 있으면 임베딩은 같은 방식으로 무너진다. 픽셀 예산은 조명을 아예 계산에 넣지 않는다. 이건 낙관치의 문제가 아니라 계산이 다루지 않는 축이다.
실제 렌즈로 실측해 보정하기 전까지 이 숫자를 사양으로 읽으면 안 된다. 지금 상태로 공개된 숫자는 물리적 완성품이 그 아래에 놓일 천장이다. 프라이버시 주장에는 안전한 방향이고 성능 주장에는 위험한 방향이다. 정직하게 읽으면 이렇다. 대략 1.5미터를 넘으면 식별이 불가능하고, 그보다 조금 가까운 데서도 불가능할 수 있다.
아직 재야 하는 것
못 잰 목록은 짧고 구체적이다. 출하될 렌즈로 잰 실제 프레임의 얼굴 픽셀. 중앙부터 코너까지 전부. 사무실 조명이 아니라 전시장 조명에서의 1.5미터 인식 정확도. 고른 프로세서가 1080p30 세 개를 지속 부하로 동시 인코딩할 수 있는지. 마지막 항목은 사양서의 단일 스트림 최대치로는 답이 안 된다. 셋 다 아직 숫자가 없다.
실측보다 계산을 먼저 내놓는 게 정당해지는 길은 하나뿐이다. 요구사항은 하드웨어가 무엇을 틀리면 안 되는지를 말한다. 성능 수치는 완성된 물건이 얼마나 잘 도는지를 말한다. 위 표는 앞의 것이다. 두 대화를 갈라내는 문제에서 무엇을 주장하고 무엇을 주장하지 않는지를 가르는 것도 같은 구분이다. 거기에도 정확도 수치는 없다. 재지 않은 값이 필요한 주장이면 메모란은 비워 두는 편이 맞다.
여기서 나오는 설계는 좁다. 항목 대부분이 거절로 이루어져 있다. 카운터에 놓여 테이블 건너를 겨누는 카메라 한 대. 거기서 일하는 사람은 알아본다. 테이블이 끝나는 지점부터는 아무도 알아보지 않는다. 아무도 착용하지 않고, 아무도 켜지 않고, 2미터 밖 방문객은 존재로만 남는다. 끝까지 이름은 아니다.